¿Qué es el aprendizaje por refuerzo y cómo se aplica en la vida real?

El aprendizaje por refuerzo (RL, por sus siglas en inglés) es una rama fascinante de la inteligencia artificial que se inspira en cómo los humanos y los animales aprenden a través de la experiencia. En esencia, un agente de RL aprende a tomar decisiones en un entorno para maximizar una recompensa acumulada. No se le dice explícitamente qué acciones debe realizar, sino que descubre la mejor estrategia mediante un aprendizaje por prueba y error, recibiendo retroalimentación positiva (recompensas) o negativa (penalizaciones) por sus acciones. Este proceso iterativo le permite al agente mejorar su comportamiento con el tiempo.
A diferencia del aprendizaje supervisado, donde se entrena un modelo con datos etiquetados, o del aprendizaje no supervisado, donde el modelo busca patrones por sí solo, el aprendizaje por refuerzo se centra en la interacción con un entorno dinámico. Esto lo hace especialmente adecuado para problemas donde no existe un conjunto de datos "correcto" para aprender, o donde el entorno cambia constantemente.
El potencial del aprendizaje por refuerzo es enorme y cada vez vemos más aplicaciones prácticas en diversos campos, desde la robótica y los videojuegos hasta la gestión de recursos y la optimización de sistemas complejos. Exploraremos estos ejemplos y conceptos clave a continuación.
¿Cómo funciona el aprendizaje por refuerzo?
El aprendizaje por refuerzo se basa en un bucle fundamental que involucra a un agente, un entorno, acciones, recompensas y estados. Intentemos desglosarlo:
- Agente: Es el "aprendiz" que interactúa con el entorno.
- Entorno: Es el mundo en el que el agente opera y con el que interactúa.
- Acciones: Son las decisiones que el agente puede tomar en un estado determinado.
- Recompensas: En el aprendizaje por refuerzo, las recompensas son las señales que indican al agente si una acción fue beneficiosa o perjudicial, y diseñarlas bien resulta clave: una recompensa mal planteada puede llevarlo a explotar atajos inesperados. Una recompensa positiva refuerza la conducta, mientras que una penalización (recompensa negativa) busca que el agente evite ese estado o acción en el futuro.
- Estado: Es una representación de la situación actual del entorno.
En este bucle, los agentes de aprendizaje por refuerzo observan el estado del entorno, eligen una acción, reciben una recompensa y el entorno pasa a un nuevo estado. Este ciclo se repite continuamente, y cada agente debe equilibrar la exploración, probar acciones nuevas, con la explotación, aprovechar las que ya sabe que funcionan, para maximizar su recompensa acumulada a largo plazo.
La política en el aprendizaje por refuerzo ($\pi$) es la estrategia o función que el agente utiliza para decidir qué acción tomar basándose en el estado actual. El objetivo es encontrar la política óptima, aquella que maximice la suma de recompensas esperadas a largo plazo y no solo la recompensa inmediata: el agente puede renunciar a un beneficio inmediato si ese sacrificio le reporta una mayor recompensa acumulada.
Aplicaciones del aprendizaje por refuerzo en la vida real
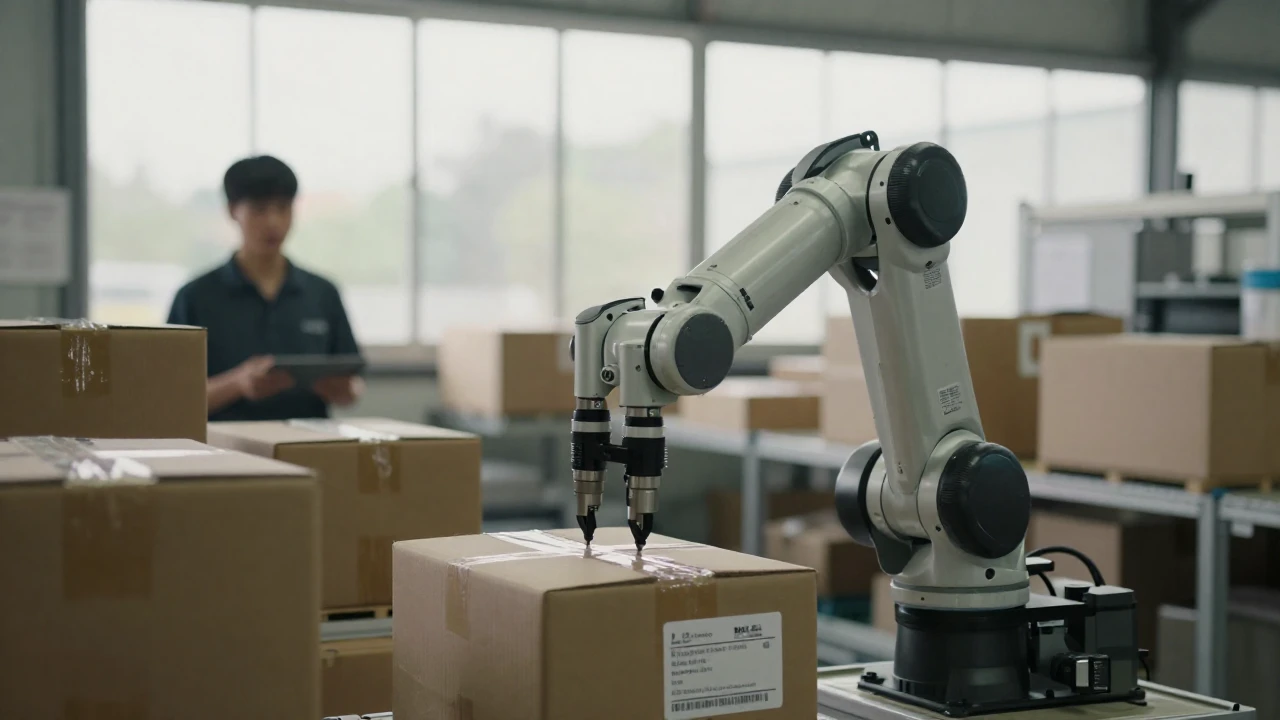
El aprendizaje por refuerzo ha dejado de ser una curiosidad académica para convertirse en una herramienta poderosa con aplicaciones cada vez más extendidas:
-
Videojuegos: Es uno de los campos de mayor éxito para los algoritmos de aprendizaje por refuerzo. AlphaGo venció al campeón mundial Lee Sedol en Go en 2016, y agentes como AlphaStar han llegado a superar a jugadores profesionales en StarCraft II. El RL permite que la IA descubra tácticas que los humanos nunca habían imaginado, mediante la exploración de millones de partidas contra sí misma.
-
Robótica: El aprendizaje por refuerzo en robótica es una de sus áreas más prometedoras: permite enseñar a los robots tareas complejas como caminar, correr, manipular objetos o navegar en entornos desconocidos. En lugar de programar manualmente cada movimiento, el robot aprende por sí solo mediante prueba y error, aunque en hardware real conviene ensayar antes en simulación por seguridad y rapidez.
-
Gestión de recursos y optimización: Se utiliza para la eficiencia energética en centros de datos, la gestión inteligente de redes eléctricas (smart grids) y la optimización de la logística de inventarios. En 2016, el equipo de DeepMind mostró que un sistema de aprendizaje por refuerzo lograba reducir en torno a un 40 % la energía destinada a la refrigeración de los centros de datos de Google. El agente aprende a equilibrar la oferta y la demanda en tiempo real para minimizar el desperdicio y los costes operativos.
-
Finanzas: El aprendizaje por refuerzo en finanzas se emplea en el desarrollo de estrategias de trading automatizado, la gestión de carteras de inversión y la evaluación de riesgos. Un agente de RL puede aprender a tomar decisiones de inversión según las condiciones del mercado, aunque su naturaleza cambiante obliga a interpretar los resultados con cautela y a validarlos con datos históricos antes de aplicarlos con dinero real.
-
Sistemas de recomendación: A diferencia de los métodos estáticos, el RL permite que los algoritmos de recomendación de contenido (como en plataformas de streaming o e-commerce) se adapten al cambio de intereses del usuario en tiempo real, optimizando la satisfacción a largo plazo en lugar de solo buscar el clic inmediato.
-
Conducción autónoma: Aunque a menudo se asocia con otras técnicas de IA, el aprendizaje por refuerzo en conducción autónoma resulta útil para la toma de decisiones en maniobras difíciles de programar a mano, como incorporarse al tráfico o negociar un cruce, y para adaptarse a condiciones variables de circulación.
Desafíos y futuro del aprendizaje por refuerzo
A pesar de su potencial, el aprendizaje por refuerzo enfrenta desafíos técnicos significativos. El principal es la ineficiencia de muestra: los agentes suelen requerir millones de interacciones para dominar incluso tareas simples, un coste que en el mundo real suele ser inasumible y que obliga a entrenar primero en simuladores, con la consiguiente necesidad de una capacidad de cómputo masiva y de modelos del entorno muy precisos.
Otro desafío es la generalización, o transferencia de aprendizaje sim-to-real: la dificultad de que un agente aplique lo aprendido en un entorno simulado a un entorno real. Un robot entrenado en un entorno virtual perfecto puede fallar en el mundo físico por pequeñas variaciones de fricción, iluminación o gravedad; para mitigarlo se recurre a técnicas como la aleatorización del dominio, que exponen al agente a muchas variaciones del entorno durante el entrenamiento.
Finalmente, la seguridad y la confiabilidad son aspectos críticos, especialmente en aplicaciones como la robótica y la conducción autónoma. Es importante asegurarse de que el agente de RL no tome decisiones peligrosas o inesperadas.
El futuro del aprendizaje por refuerzo es prometedor. La investigación actual se centra en el desarrollo de algoritmos más eficientes, técnicas de transferencia de aprendizaje mejoradas y métodos para garantizar la seguridad y la confiabilidad. A medida que estas tecnologías maduren, podemos esperar ver aplicaciones aún más innovadoras del aprendizaje por refuerzo en una amplia gama de campos.
Deja una respuesta
Entradas relacionadas